交易智能

 销售团队智能
 市场智能
 CRM系统
 呼叫中心
 在线会议平台
 IM通讯


 企业服务
 消费医疗
 教育
 汽车
 房地产
 金融
 销售人员
 销售管理
 交易跟进
 培训辅导

 全部
 白皮书
 销售会话智能

销售团队引入AI陪练,选型阶段最该追问哪些核心训练指标
当你坐在AI陪练系统的选型演示现场,看着屏幕上的销售代表与虚拟客户对话时,真正该关注的不是界面是否炫酷,也不是话术库是否庞大,而是这套系统能否在训练过程中制造真实的”认知冲突”——即当销售按惯性出牌时,AI客户是否具备足够的智能来打破这种惯性,迫使销售在压力下重新组织语言、调整策略。这正是多数企业在选型阶段容易忽略的关键:他们急于对比功能清单,却忘了追问那些决定训练质量的核心指标。
AI客户是否具备”刁难”你的能力
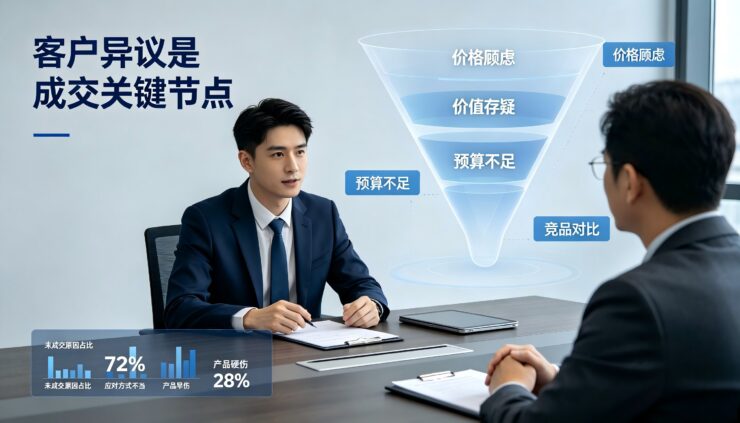
在评估AI陪练系统时,第一个需要验证的指标是多智能体协同下的客户拟真度。很多系统提供的AI客户只是简单的问答机器人,按照预设脚本推进对话,这种训练本质上仍是”背台词”的数字化版本。真正有效的训练需要AI客户具备不确定性、情绪变化和需求隐藏能力。
深维智信Megaview的Agent Team架构在此展现出差异化价值。其系统并非单一AI角色,而是由客户Agent、教练Agent、评估Agent组成的协作网络。当你观察演示时,应特别注意AI客户是否会突然转变态度——比如从最初的温和询问转为质疑产品价值,或者在销售介绍功能时突然打断并提出尖锐的价格异议。这种”刁难”不是随机设置,而是基于200+行业销售场景和100+客户画像的动态剧本引擎在起作用。
更重要的是,优秀的AI陪练应该让销售在训练中经历”卡壳—调整—突破”的完整循环。如果AI客户只是被动接受销售的话术投喂,那么训练就变成了单方面的演讲练习。你需要追问供应商:当销售使用标准话术应对时,AI客户能否识别出其中的套路化表达,并进一步施压?这种能力直接决定了销售在真实战场上面对客户质疑时的心理准备程度。
业务知识是否真正”长”在AI体内
第二个核心指标关乎知识融合的深度。许多AI陪练系统声称支持行业定制,但实际上只是简单上传PDF文档作为知识库,导致AI客户在对话中要么机械引用条款,要么在涉及具体业务场景时露出马脚。真正的考验在于AI是否理解了行业语境中的微妙差别——比如医药代表拜访医生时,学术讨论与商业推广之间的界限;或者B2B销售中,技术部门与采购部门关注点的差异。
这就要求系统具备深度的领域知识内化能力。深维智信Megaview的MegaRAG技术架构不仅存储企业私有资料,更重要的是通过检索增强生成机制,让AI客户”理解”而非”记忆”业务知识。在选型演示中,你可以设计一个陷阱:让销售在对话中提及某个特定行业的监管限制或技术参数,观察AI客户是否能基于行业常识做出符合逻辑的反应,而不是泛泛而谈。
此外,动态剧本引擎的支持度也是关键指标。系统是否内置了SPIN、BANT、MEDDIC等10+主流销售方法论,并能将这些方法论转化为具体的对话压力点?比如当销售试图使用SPIN技法挖掘需求时,AI客户是否会根据情境模型给出不同程度的配合或抗拒,从而训练销售在不同阻力下的提问技巧?这种将抽象方法论转化为具体训练场景的能力,是区分工具化陪练与智能化陪练的分水岭。
评估颗粒度能否定位到”一句话的失误”
训练后的反馈机制是第三个不可忽视的指标。笼统的评分(如”沟通能力85分”)对销售改进毫无帮助,你需要的是能定位到具体话术缺陷的显微镜级评估。在观察系统的评估报告时,重点看其评分维度是否足够细分,能否指出销售在某一轮对话中具体哪句话导致了客户态度的转折。
深维智信Megaview围绕表达能力、需求挖掘、异议处理、成交推进、合规表达等5大维度建立的16个粒度评分体系,正是为了解决这一痛点。当销售完成一次模拟拜访后,系统生成的能力雷达图不应只是展示分数,而应指出诸如”在客户需求确认环节,连续使用了三个封闭式提问,导致对话陷入僵局”这样具体的改进点。
更深入的指标是评估的时效性。理想的AI陪练应该在对话结束后立即生成反馈,而不是等待批量处理。你需要验证系统是否支持实时语音分析,能否在训练过程中就通过教练Agent给予提示,以及在复盘时能否回溯到具体的对话节点。这种即时反馈机制将错误转化为当下的学习机会,而不是事后的模糊记忆。
错误如何转化为下一轮训练的”燃料”
最后一个关键指标是闭环效率——即系统如何将本次训练的发现转化为下一次训练的输入。很多AI陪练停留在”练习-评分-结束”的线性流程,但真正的能力提升来自于螺旋上升的复训机制。你需要追问:当销售在某个场景表现不佳后,系统能否自动生成针对性的强化训练方案?
在这方面,深维智信Megaview的学练考评闭环设计值得关注。其团队看板功能不仅展示谁练了、练了多少,更重要的是标记出每个人的能力短板,并自动推送相关的微课程和针对性对练场景。例如,如果系统发现某销售在应对价格异议时 consistently 表现薄弱,它会自动调整该销售的训练计划,增加高压力的价格谈判场景,并降低难度梯度,直到该销售掌握应对技巧。
此外,观察系统是否支持”错题本”式的累积学习。优秀的AI陪练会记录销售在历次训练中重复出现的错误模式,并在后续对话中刻意设置类似的陷阱,检验销售是否真正改进了话术。这种基于历史数据的动态调整能力,确保了训练不是重复劳动,而是精准的能力修补。
当你完成一轮选型评估,回到会议室讨论采购决策时,建议用这四个指标重新审视候选系统:能否制造真实的对抗、是否理解业务语境、评估是否足够细腻、错误能否驱动复训。功能列表上的勾选框只能证明系统”有什么”,而这些核心训练指标才能证明系统”能训出什么”。毕竟,引入AI陪练的目的不是完成培训任务,而是让销售在虚拟战场上经历的每一次挫败,都转化为真实签单时的胜算。