交易智能

 销售团队智能
 市场智能
 CRM系统
 呼叫中心
 在线会议平台
 IM通讯


 企业服务
 消费医疗
 教育
 汽车
 房地产
 金融
 销售人员
 销售管理
 交易跟进
 培训辅导

 全部
 白皮书
 销售会话智能

训练数据多就一定好?B2B大客户销售AI培训效果的反常识判断清单
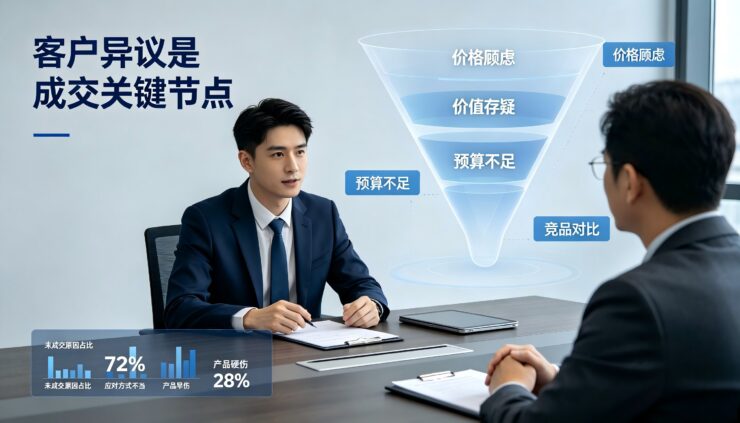
…会议室里的空气突然凝固。你刚刚讲完产品架构,对面的采购总监放下钢笔,身体后倾,十指交叉放在胸前——那个你曾在培训视频里看过无数次的”防御性沉默”姿势。你的喉咙发紧,准备好的SPIN提问法在脑子里乱成一团,脱口而出的是:”您…还有什么顾虑吗?”对方挑了挑眉,没有接话。三秒钟的沉默像三分钟那么长,你开始自我辩解,语速越来越快,直到客户抬手看表。
这是B2B大客户销售最真实的压力现场,也是大多数AI陪练系统无法复现的灰色地带。当行业都在比拼”训练数据量”——十万条对话、百万级语料、亿级参数——我们却发现一个反常识的现象:数据堆砌与实战能力之间,往往隔着一道名为”场景颗粒度”的鸿沟。基于对多个行业销售团队训练效果的跟踪评估,我们整理出这份判断清单,帮助培训负责人识别什么样的AI陪练,才能真正让销售在高压客户面前保持冷静与专业。
当客户突然沉默——测试场景的拟真度比数据量更重要
很多企业在选型时会问:”你们的AI客户有多少种对话路径?”仿佛路径数量等同于训练价值。但在实际陪练中,真正决定训练效果的,是系统能否还原那种让销售手心出汗的压迫感。
评估一个AI陪练系统的首要维度,不是它吞下了多少GB的语料,而是它能否在关键时刻”制造”客户的沉默、质疑和突然转折。深维智信Megaview的Agent Team多智能体协作体系,正是通过不同角色的智能体分工——有的扮演挑剔的技术负责人,有的扮演关注预算的采购经理,有的专门在对话中制造冷场——来构建这种高拟真的压力场景。这不是简单的问答匹配,而是基于200+行业销售场景和100+客户画像的动态博弈。
关键判断点:观察AI客户在销售表达出现逻辑漏洞时,是会机械地按照剧本继续提问,还是会像真实客户那样突然沉默,或用”这个我不关心”来打断节奏。只有后者,才能训练销售在失控边缘快速调整呼吸、重组话术的能力。数据量再大,如果缺乏这种”压迫性反馈”,练出来的只是背诵能力,而非应变能力。
当需求被连环质疑——动态剧本引擎决定训练深度
在B2B销售中,最致命的不是客户说”太贵了”,而是客户说:”你确定你理解我们的业务痛点了吗?”当AI客户开始连环追问行业Know-how,很多基于固定话术库的训练系统会瞬间露馅——它们只能按照预设的A-B-C路径回应,无法针对销售回答中的专业漏洞进行深度挖掘。
这引出了第二个反常识判断:训练数据的多寡,不如数据与业务场景的咬合度重要。一个拥有百万条通用销售对话的系统,可能不如一个融合了企业私有资料、能动态生成追问的引擎有效。深维智信Megaview的MegaRAG领域知识库,允许企业将自身的产品手册、过往成交案例、技术白皮书甚至失败项目的复盘报告注入系统。这意味着,当销售在陪练中试图用通用话术搪塞时,AI客户能够基于真实的行业知识进行反驳。
关键判断点:测试系统是否能针对你所在行业的特定痛点生成追问。比如医药行业的AI客户应该能质疑学术推广数据的严谨性,汽车行业的AI客户应该能追问供应链本地化率。如果AI客户只能问出”你们价格怎么样”这种通用问题,无论背后有多少训练数据,都无法提升销售的专业说服力。
当异议超出标准话术库——多轮对抗中的知识涌现能力
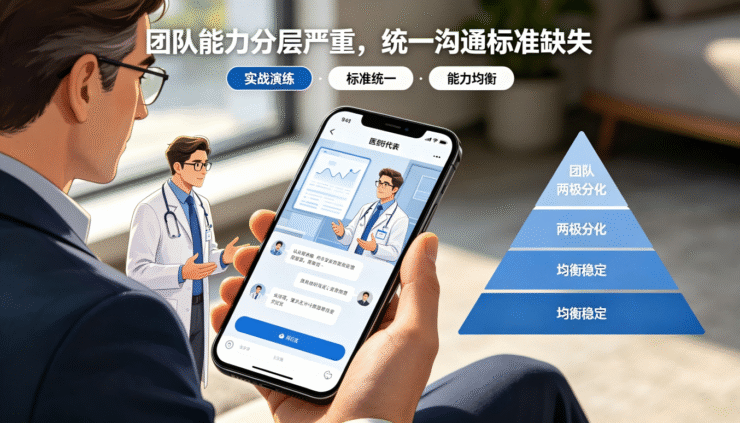
销售培训中最常见的挫败感来自于:课堂上背熟了50种异议处理方法,实战中客户却提出了第51种。传统的AI陪练往往基于静态知识库,当销售的话术偏离标准答案,系统要么无法识别,要么给出机械的错误提示。
这揭示了第三个判断维度:优秀的AI陪练应该具备”越练越懂业务”的进化能力,而非依赖预置的庞大语料。深维智信Megaview的动态剧本引擎,结合MegaAgents应用架构,支持多轮对话中的上下文理解和意图识别。更重要的是,它支持5大维度16个粒度的能力评分——从需求挖掘的深度、异议处理的精准度,到商务谈判的节奏控制、合规表达的严谨性。
关键判断点:观察系统在销售给出”非标准但有效”的回答时,是否能识别其合理性并给予正向反馈,而不是死板地扣分外。同时,查看系统是否能生成能力雷达图,清晰展示销售在”高压下的逻辑完整性” versus “话术流畅度”之间的平衡能力。数据量大的系统如果只有”对错”二元判断,会扼杀销售的创造性应对;而精细化的评分维度,才能让销售看清自己在真实对抗中的真实短板。
当团队规模扩大——可复训性比一次性通关更重要
许多企业陷入的另一个误区是:追求”一次培训,全员通关”的幻觉。他们收集海量数据训练AI,希望销售练几次就能掌握复杂的大客户谈判技巧。但现实是,B2B销售能力的形成需要高频次的犯错-纠正-再尝试。
这也是评估AI陪练系统的最终边界:它是否支持持续复训,而非一次性考试。深维智信Megaview的学练考评闭环设计,不是为了让销售在模拟中拿高分,而是为了建立”训练-反馈-针对性复训”的飞轮。通过团队看板,管理者能看到谁在与AI客户的对抗中反复卡在”需求确认”环节,谁在”成交推进”时过度承诺——这些细节在传统的数据密集型训练中往往被平均数掩盖。
关键判断点:询问系统是否支持针对同一销售的不同短板,自动生成差异化的复训剧本。比如,对于表达能力弱但逻辑清晰的销售,AI客户应该增加打断频率来训练其简洁表达;对于过于激进的销售,AI客户应该设置更严格的合规检查点。只有这种个性化的、可重复的对抗训练,才能让销售在真实客户面前,把曾经导致失控的场景变成肌肉记忆。
训练数据就像销售手中的名片,数量多不如质量精,覆盖广不如场景深。在B2B大客户销售这个高 stakes 的领域,AI陪练的价值不在于它”知道”多少对话,而在于它能否在关键时刻让销售”体验”到那种即将失去客户的窒息感,并从中学会呼吸。
真正的销售能力,从来不是从海量数据中学来的,而是在无数次具体的、痛苦的、针对自身短板的复训中磨出来的。选择AI陪练系统时,不妨少问”你们有多少数据”,多问”你们能让我的人练多少次,错多少次,又能精准地纠正多少次”。毕竟,在面对那个沉默的采购总监时,销售需要的不是背诵过千万条话术的安全感,而是经历过百次高压模拟后的那份笃定。