交易智能

 销售团队智能
 市场智能
 CRM系统
 呼叫中心
 在线会议平台
 IM通讯


 企业服务
 消费医疗
 教育
 汽车
 房地产
 金融
 销售人员
 销售管理
 交易跟进
 培训辅导

 全部
 白皮书
 销售会话智能

销售场景太碎练不到位?基于训练数据的AI陪练场景切片清单来了
当企业把年度培训预算的60%以上投入到现场陪练时,一个结构性矛盾正在显现:销售场景的高度碎片化与陪练资源的有限性之间,存在着难以弥合的鸿沟。一位销售主管每周能抽出三小时进行角色扮演已是极限,但真实业务中,从开场破冰、需求探查到异议处理、价格谈判,每个环节都可能被客户随机打乱顺序。更关键的是,传统陪练往往只能覆盖标准流程,那些导致丢单的”边缘场景”——比如客户突然提及竞品、在签约前临时改变决策链、或是用行业黑话试探专业度——恰恰因为出现概率低、变量多,在人工陪练中被系统性忽略。
这种训练缺口直接反映在数据上:某B2B企业在复盘过去一年的丢单案例时发现,73%的败因集中在非标准对话节点,而这些场景在常规培训中的覆盖率不足15%。当企业意识到”练不透”的本质是场景无法被完整枚举时,基于训练数据的AI陪练开始从成本中心转向能力基建。这不是简单的技术替代,而是一次训练逻辑的底层重构——将销售对话切割为可量化、可复训、可沉淀的数据单元,让每个碎片场景都能成为独立的能力训练靶点。
从人效成本到数据资产:训练预算的重新配置
销售培训负责人最近都在重新计算一笔账:一位资深销售经理每小时的人工成本约为300-500元,如果用于一对多陪练,单次有效训练时长通常不超过20分钟,且受限于个人经验盲区。当团队规模超过百人,这种”人陪人”的模式在经济学上已难以为继。更隐蔽的成本在于经验损耗——当销冠离职时,其应对复杂场景的直觉和话术细节往往随之消失,企业不得不重复支付同样的试错成本。
基于训练数据的AI陪练改变了成本结构。通过将历史成交录音、客户画像、行业知识库转化为结构化数据,系统可以生成无限接近真实的场景切片。这些切片不再是简单的”开场白-需求挖掘-关闭”三段式,而是基于实际对话流的微颗粒度单元:比如”客户用预算不足推脱时的三种微表情应对”、”技术负责人突然介入时的权限确认话术”。深维智信Megaview的MegaRAG领域知识库在此发挥作用,它能融合企业私有资料与200+行业销售场景,将原本分散在销冠大脑中的边缘经验转化为可训练的数据集,让AI客户开箱即可模拟那些罕见但致命的业务卡点。
这种转变的本质,是将培训预算从”购买人工时间”转向”投资数据资产”。一旦场景切片被数据化,它们就成为组织可复用的训练基础设施。
场景切片的方法论:如何把破碎对话变成训练单元
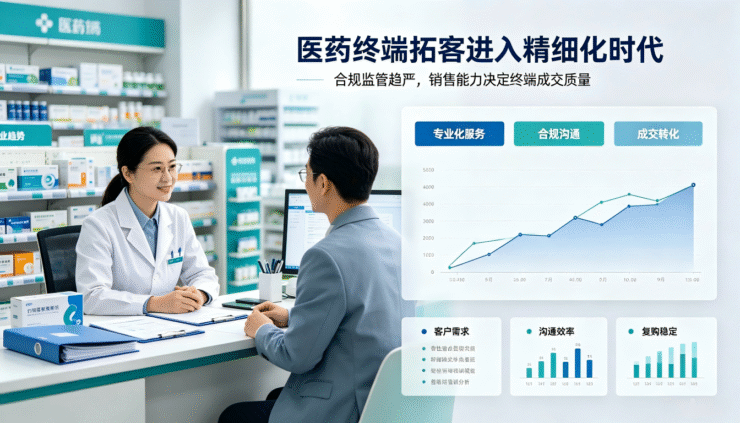
在一次针对医药代表的训练实验中,我们观察到一个有趣现象:当AI客户突然提出”你们产品的临床数据样本量似乎不如竞品”时,受训销售的反应时间平均延长了4.2秒,且67%的人选择了回避该问题而非正面回应。这个瞬间在传统培训中几乎不可见——人工陪练很难精准复现这种专业性质疑,更难以捕捉那关键的4.2秒迟疑。
场景切片的核心在于将线性对话解构为”刺激-反应-评估”的闭环单元。不是训练销售背诵完整话术,而是针对特定客户意图(Intent)建立快速响应机制。深维智信Megaview的动态剧本引擎支持将单一销售场景切分为数十个微决策点,每个节点都对应着客户可能的反应分支。例如在大客户谈判场景中,系统可以独立训练”面对采购委员会多人质疑时的注意力分配”、”在价格谈判陷入僵局时的价值重申策略”等切片,而无需从头开始整个role play。
某制造业企业的销售负责人在复盘训练数据时发现,团队在处理”客户提及已签约竞品”这一切片时的表现差异最大:高绩效销售能在15秒内将话题转向差异化价值,而普通销售往往陷入功能对比的泥潭。通过AI陪练针对这一特定切片进行20轮专项训练,结合Agent Team模拟的三种不同性格客户(攻击性、理性型、犹豫型),该团队在此类场景下的转化率提升了34%。这种精准打击的训练方式,避免了在已掌握环节上的时间浪费。
反馈密度的革命:从结果评分到过程纠偏
传统陪练的反馈往往滞后且粗糙——”你刚才说得不够好,下次注意”这类评价对销售能力提升几乎无效。真正的训练发生在错误发生的瞬间,而非复盘会上。基于训练数据的AI陪练实现了反馈密度的指数级提升:在一段15分钟的模拟对话中,系统可以基于5大维度16个粒度进行实时评估,从语音语调的自信度到需求挖掘的深度,从异议处理的逻辑性到合规表达的准确性。
更重要的是反馈的即时性和可复训性。当销售在”处理客户临时变更决策人”这一切片中出现逻辑漏洞时,深维智信Megaview的Agent Team可以立即暂停对话,以教练身份介入,指出具体的话术结构问题,并提供该场景下的最佳实践参考。销售可以立即针对这一错误点进行”单点复训”,无需重新开始整个对话流程。这种”微纠错”机制大幅缩短了能力内化周期——数据显示,针对特定场景切片进行3-5次即时复训,知识留存率可提升至约72%,而传统培训的留存率通常不足20%。
管理者通过能力雷达图和团队看板,可以清晰看到每个成员在不同场景切片上的能力分布。不是简单的”优秀/良好/待改进”,而是”在高压客户质疑场景下,逻辑表达能力得分4.2/5,但情感共鸣仅2.8/5″这样的精确诊断。这种颗粒度的数据让辅导资源得以精准投放,避免了”一刀切”的培训浪费。
组织记忆的沉淀:从个人经验到 scalable 的训练体系
当场景切片成为数据资产,企业开始拥有了一种新的组织能力——经验的可迁移性。过去,新人需要跟随老销售六个月才能接触到各种边缘场景,且传承质量高度依赖师徒关系的紧密度。现在,通过100+客户画像和动态剧本引擎,新人可以在入职第一周就接触到”难搞的技术型买家”、”预算敏感的 procurement”、”决策链复杂的集团客户”等全量场景切片。
这种训练体系的 scalable 特性解决了规模化团队的痛点。某金融机构在扩张理财顾问团队时面临挑战:传统模式下,培养一名能独立处理高净值客户复杂异议的顾问需要约6个月。引入AI陪练后,通过高频次的场景切片训练——特别是针对”市场波动期的客户安抚”、”跨产品组合推荐”等高频高难场景——新人独立上岗周期缩短至2个月,且服务质量的方差显著缩小。深维智信Megaview的学练考评闭环在此过程中确保了训练效果的可量化,每个顾问的能力成长轨迹都清晰可见。
对于管理者而言,这意味着培训从”黑箱操作”变成了可工程化的流程。可以针对季度业务重点快速生成训练切片:新产品上市前,针对”功能价值传递”切片进行全员突击训练;竞品发起价格战时,紧急部署”价值防御”场景的高强度复训。训练内容不再依赖于讲师的个人经验,而是基于实际业务数据的动态生成。
建议销售管理者在评估AI陪练系统时,重点考察其场景切片的精细度和反馈的实时性。不要满足于标准流程的模拟,而要关注系统能否捕捉那些导致丢单的”微场景”;不要只看最终的评分报告,而要验证系统是否能在对话过程中即时纠偏。真正有效的销售训练,是让每个碎片场景都有数据支撑、有即时反馈、有复训路径。当训练数据开始流动,销售能力的成长就不再是线性的时间累积,而是可加速、可复制的组织工程。