交易智能

 销售团队智能
 市场智能
 CRM系统
 呼叫中心
 在线会议平台
 IM通讯


 企业服务
 消费医疗
 教育
 汽车
 房地产
 金融
 销售人员
 销售管理
 交易跟进
 培训辅导

 全部
 白皮书
 销售会话智能

企业负责人追问:Megaview AI陪练训练数据清单是否经得起审视?
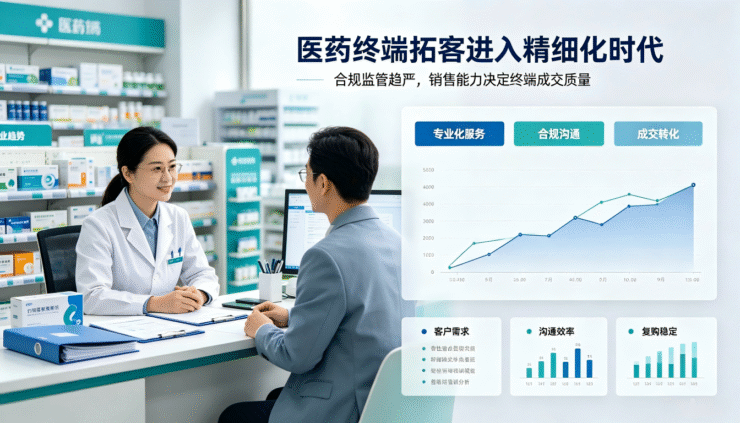
半年前,某医疗集团培训负责人老陈在复盘新人上岗项目时,发现一组刺眼的数据:经过三周密集集训的医药代表,在真实学术拜访场景中,仍有超过六成无法独立完成需求探询。复盘会上,销售总监追问的不是”课程内容够不够”,而是:”我们用于训练的数据,到底能不能还原真实的临床决策场景?”
这个问题戳破了传统培训的最后一层窗户纸。当销售培训从知识传授转向能力训练,训练数据的质量直接决定了实战能力的迁移效率。这不是简单的课程资料堆砌,而是一套包含客户画像颗粒度、场景压力系数、反馈评估维度的复杂数据链路。如果训练数据清单经不起审视,再先进的AI也只是空转。
回溯那次培训崩在数据链的第几环
老陈团队最初的训练设计看似完善:整理了产品知识库、编写了标准话术手册、录制了Top Sales的拜访视频。但在实际执行中,三个数据断层逐渐暴露。
首先是客户反应的单一性。训练用的 role-play 脚本只预设了”配合型医生”的回应路径,缺乏对质疑型、冷漠型、学术型等不同决策风格的数据采集。当新人面对真实客户突然的临床异议时,大脑里调用的仍是标准答案,而非应对策略。
其次是评估维度的缺失。当时的评分仅关注”是否说完产品卖点”,没有记录”提问深度””需求挖掘次数””异议处理逻辑”等过程数据。这导致培训结束后的能力评估形同虚设,管理者看不到销售在哪些微观交互环节存在卡点。
最关键的是知识更新滞后。医学指南半年一更新,但训练用的案例数据仍停留在上一版临床路径。当代表向医生提及已淘汰的治疗方案时,信任瞬间崩塌。
这次失败让团队意识到,AI陪练的核心价值不在于替代讲师,而在于构建一套可审视、可迭代、可追溯的训练数据体系。没有经得起推敲的数据清单,所谓的”实战陪练”只是数字化的话术复读。
拆解AI陪练训练数据清单的五个必检项
当我们将训练视为一个数据工程,清单的构建就需要覆盖从输入到反馈的全链路。以下是经过多个大型销售团队验证的必检维度,每条都对应着具体的训练场景与数据标准。
第一,客户画像的决策风格数据。 不能仅停留在”科室-职称-用药习惯”的静态标签,必须包含200+行业销售场景中提炼出的行为模式数据。例如医药拜访场景中,需要区分”循证导向型”(关注RCT数据)与”经验导向型”(关注同行案例)医生的对话触发点差异。这要求训练系统内置100+客户画像,且每个画像都带有特定的压力测试参数。
第二,动态剧本的分支逻辑数据。 销售对话不是线性流程,训练数据必须包含基于SPIN、BANT或MEDDIC等方法论设计的决策树。每个客户回应都应触发至少三种以上的销售应对路径,并标注路径背后的策略意图。这意味着剧本引擎需要支持多轮对话的状态机管理,而非简单的问答匹配。
第三,多模态的评估维度数据。 除了话术内容,还需采集语速、停顿、关键词密度、逻辑转折等微观行为数据。有效的评估应围绕表达能力、需求挖掘、异议处理、成交推进、合规表达等5大维度16个粒度展开,形成可量化的能力雷达图。这要求AI不仅能听懂内容,还能解析交互结构。
第四,领域知识的实时融合数据。 通过MegaRAG技术构建的领域知识库,需要支持企业私有资料(如内部竞品分析、最新临床文献)与通用销售方法的动态融合。训练时,AI客户应能实时调用最新产品信息提出专业质疑,确保知识留存率接近实战水平。
第五,错误模式与复训标记数据。 系统需要记录高频错误类型(如过早推销、需求误判、回避异议),并自动标记需要强化的训练节点。这些数据将驱动后续的个性化复训计划,而非统一补课。
在一场模拟拜访中验证数据颗粒度
为了验证上述清单的有效性,老陈团队引入深维智信Megaview进行了一次对照实验。训练场景设定为:向一位对竞品忠诚度较高的科室主任推广新适应症方案。
在这个模拟环境中,Agent Team多智能体协作体系展现了数据清单如何转化为训练体验。扮演客户的AI Agent并非简单读取脚本,而是基于MegaRAG知识库中该治疗领域的最新争议文献,提出了关于”长期安全性数据不足”的专业质疑——这正是真实世界中该客户类型的典型防御机制。
当受训代表试图用标准话术回避质疑时,系统立即触发了评估Agent的干预:不仅指出”回避异议”的策略失误,还在5大维度16个粒度的评分体系中,具体标记了”临床证据关联度”(维度:专业可信度,粒度:数据引用准确性)的扣分项。更关键的是,系统调用了历史Top Sales的应对录音数据,展示了如何通过”承认局限+呈现亚组分析”的方式重建信任。
这一训练片段揭示了深维智信Megaview的核心机制:它不是基于固定脚本进行对错判断,而是通过动态剧本引擎,让AI客户具备自由对话、压力模拟、需求和异议表达的高拟真能力。每一次对话都在生成新的训练数据,包括销售的语言模式、决策路径选择、情绪稳定性指标,这些数据回流后进一步优化客户画像的复杂度。
建立可复用的训练数据更新机制
单次的数据清单审核不足以支撑长期能力建设。在后续的优化中,老陈团队建立了季度性的数据审计制度:每季度抽样检查AI陪练生成的对话日志,比对真实CRM中的客户反馈记录,识别训练场景与实战场景的偏差。
例如,当发现真实客户开始频繁提及集采政策影响,而训练数据仍聚焦在产品疗效对比时,团队立即通过深维智信Megaview的动态剧本引擎,注入了新的政策应对分支。同时,利用系统的能力雷达图和团队看板,管理者可以清晰看到哪些代表在”政策解读”维度存在能力缺口,从而定向推送专项训练。
这种数据驱动的持续复训机制打破了”培训-遗忘-再培训”的恶性循环。销售能力的提升不再是依赖偶发的实战顿悟,而是基于可量化的数据反馈进行刻意练习。当训练数据清单能够随市场变化、产品迭代、客户演化而同步更新,销售团队才真正拥有了对抗能力折旧的基础设施。
训练数据清单的审视不该是一次性项目,而应成为销售运营的标准动作。只有当企业负责人敢于追问每一组训练数据的来源、颗粒度与更新频率,AI陪练才能从概念验证走向价值兑现。毕竟,销售能力的本质是对复杂交互模式的精准记忆与快速调用,而这恰恰依赖于一套经得起反复审视、持续进化的数据资产体系。